Em desenvolvimentoPlataformas
Evidence Finder
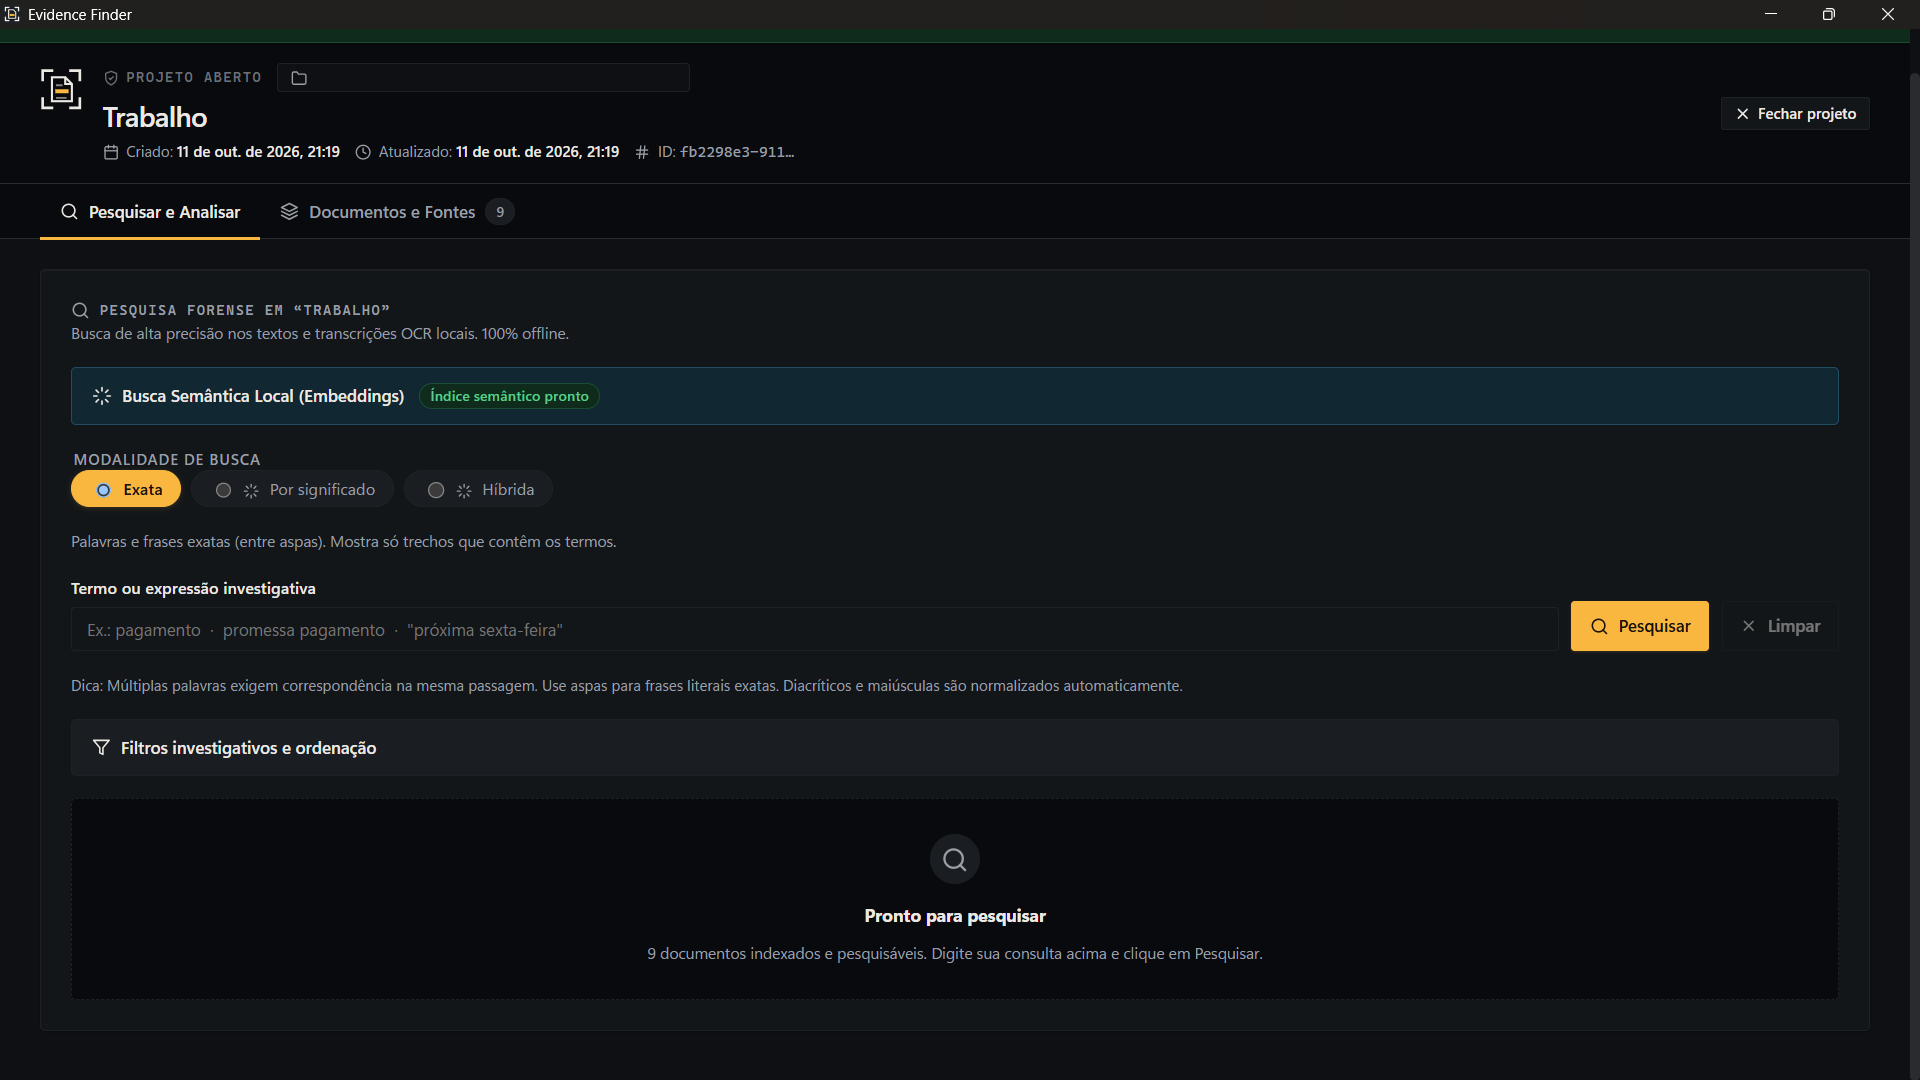
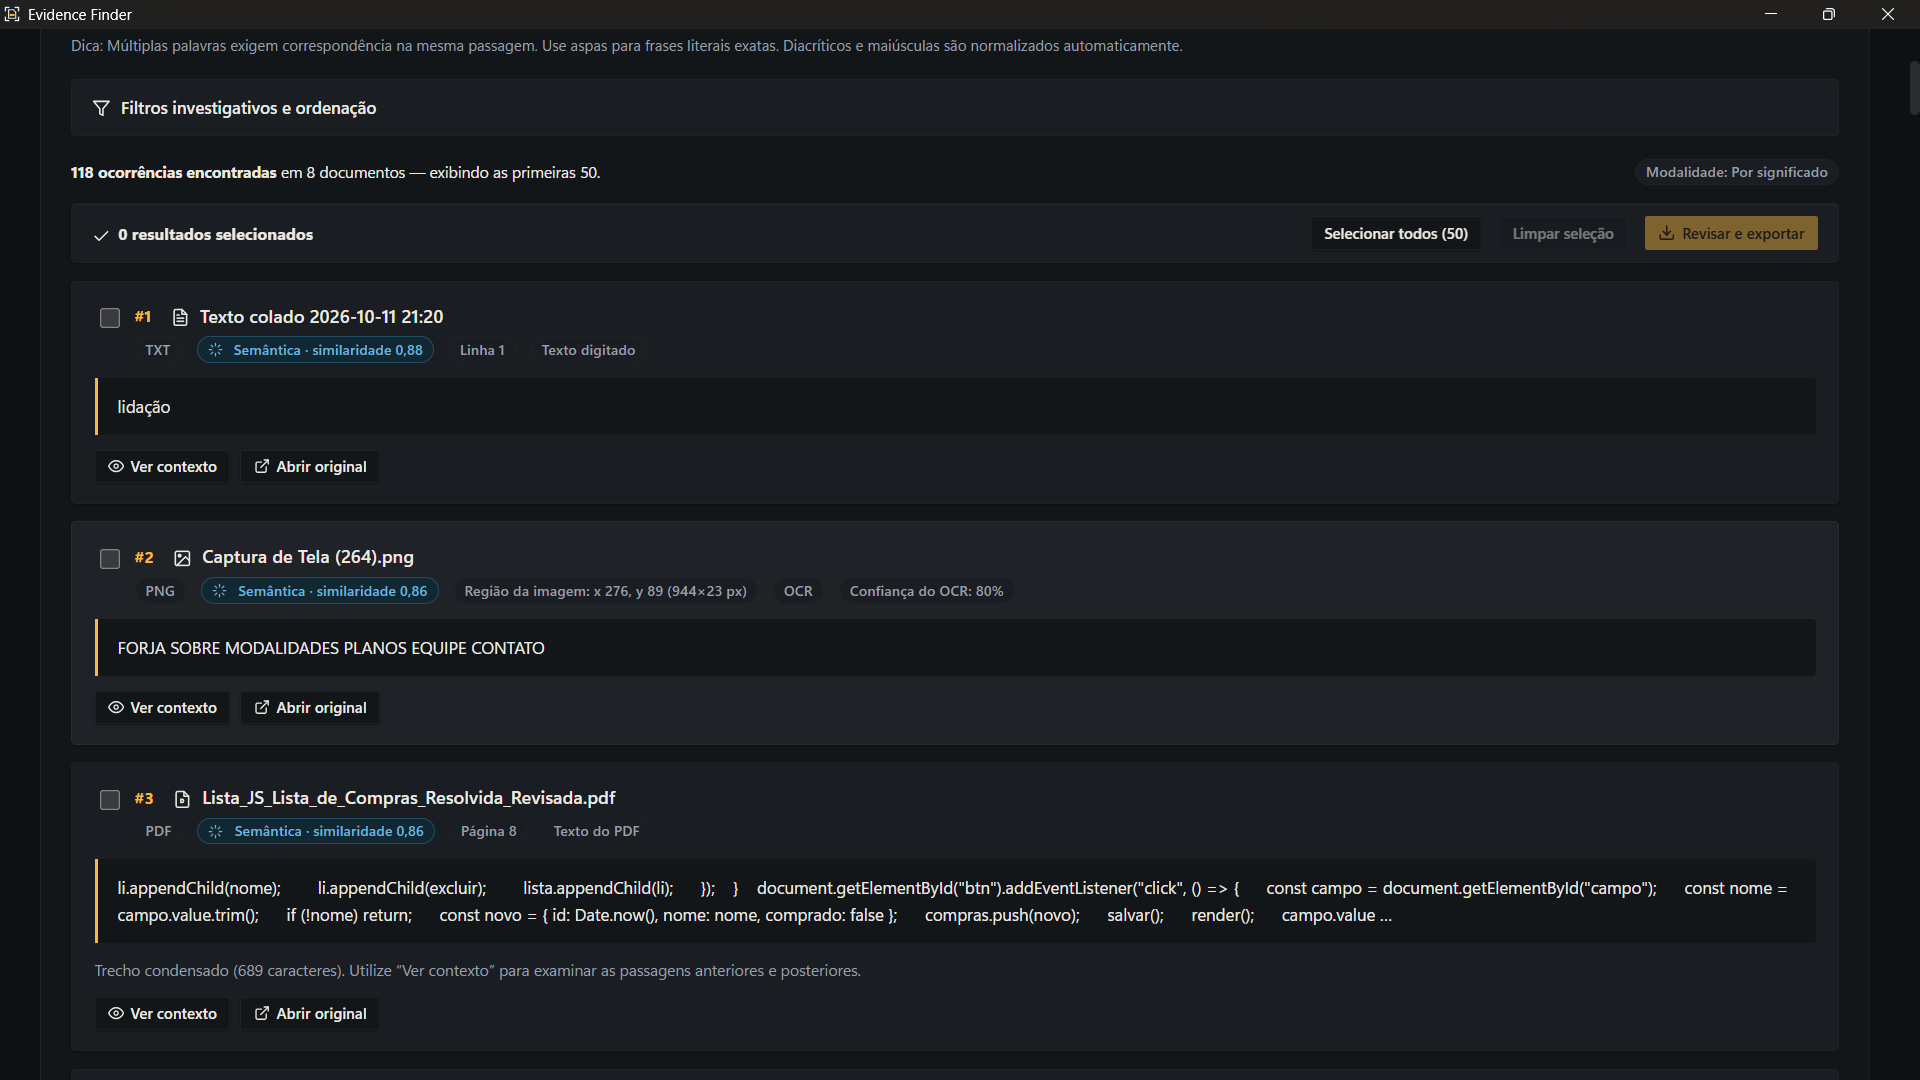
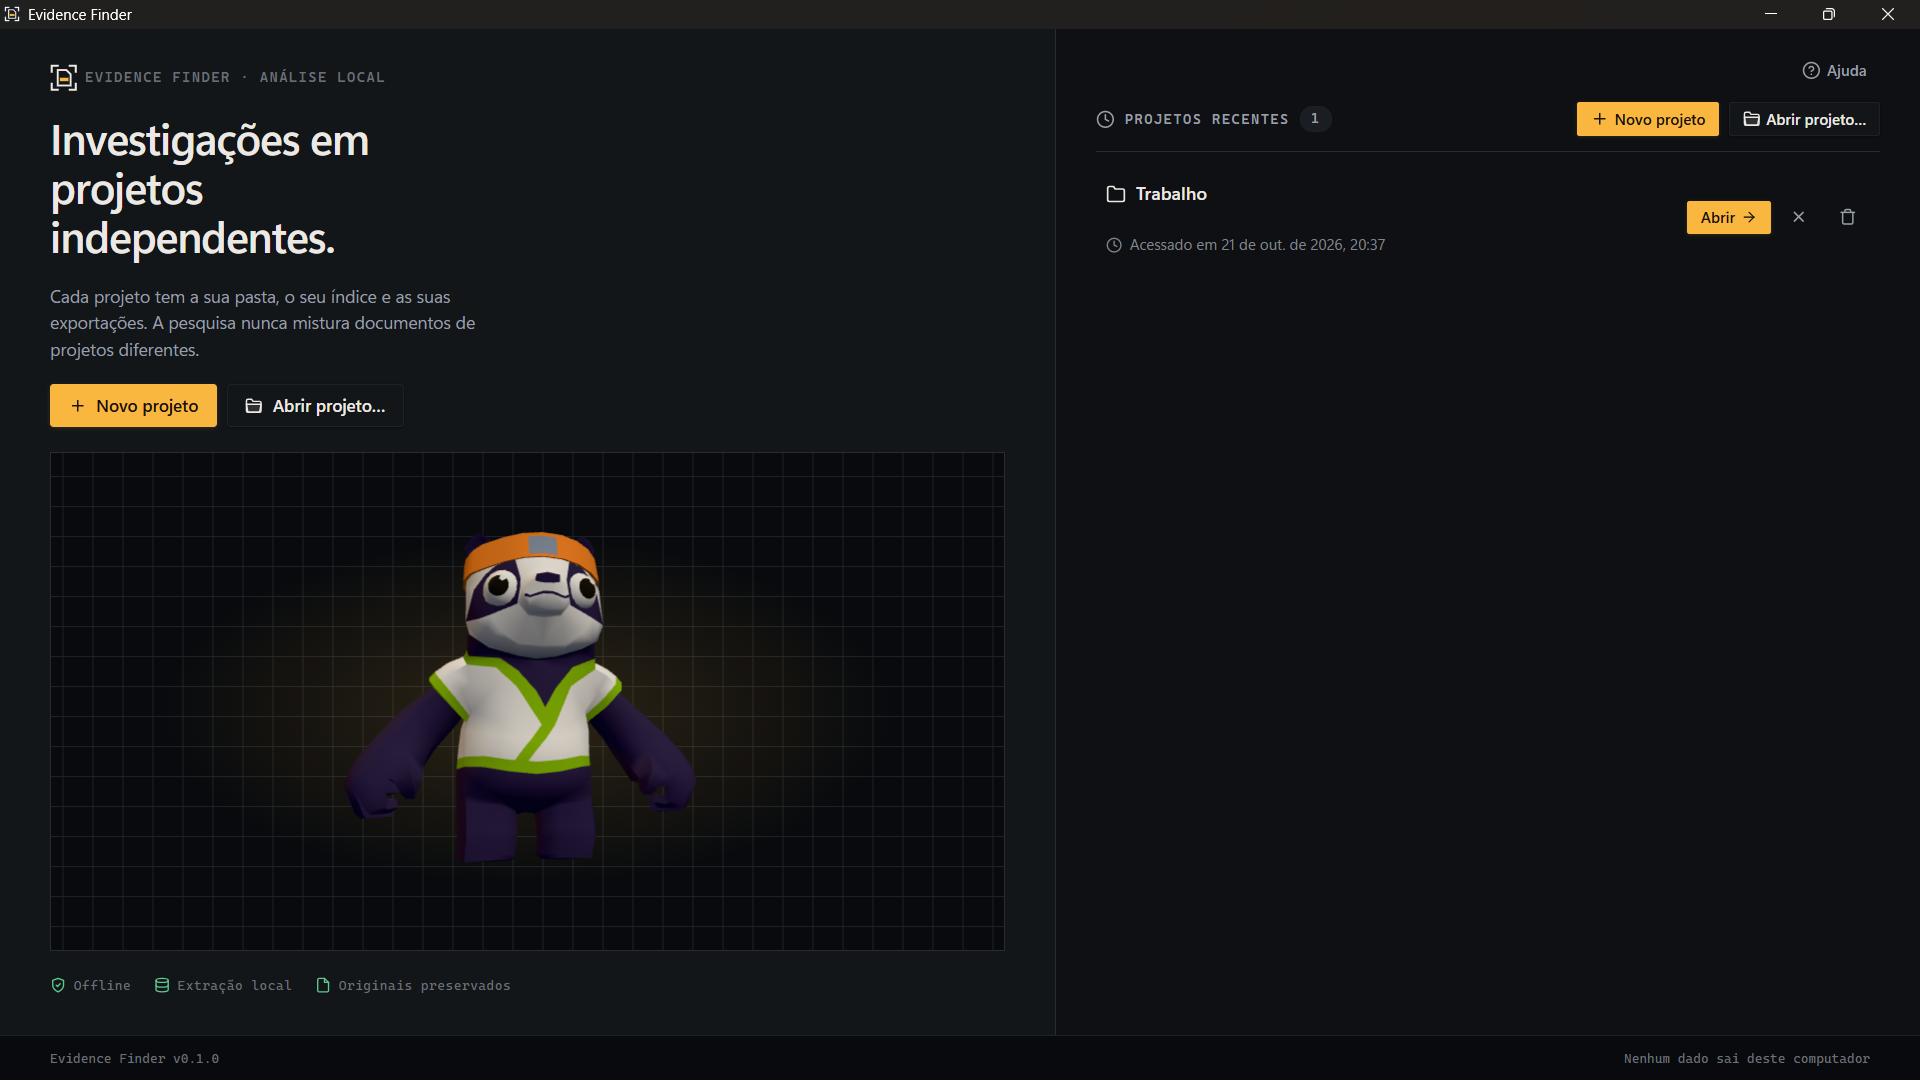
Aplicativo desktop (Tauri 2 com núcleo em Rust e interface em React) que reúne arquivos em projetos locais independentes, extrai o texto (com OCR local), permite pesquisar esse conteúdo — de forma exata, por significado ou híbrida — com trechos ligados ao documento de origem e exporta os resultados selecionados em um pacote com relatório PDF. O processamento é local: o código não contém cliente de rede nem telemetria. A versão é a 0.1.0 e o projeto está em desenvolvimento: ainda não há instalador publicado e a validação em um Windows real continua pendente.
O problema
Encontrar uma informação específica em muitas capturas de tela, PDFs e conversas exige abrir arquivo por arquivo, e é difícil provar de onde veio cada trecho.
A solução
Importar os arquivos em um projeto local, extrair o texto de cada formato, indexar tudo em SQLite (FTS5 para a busca exata e vetores locais para a busca por significado) e devolver os resultados com contexto e fonte, com SHA-256 para verificar se o arquivo continua o mesmo na exportação.
Arquitetura
- 1
React + TypeScript — telas; uma única camada de serviço (services/core.ts) conversa com o núcleo
- 2
Comandos Tauri (Rust) — superfície exposta: a interface envia só identificadores e tokens opacos, e pastas e arquivos são escolhidos em diálogos nativos abertos pelo Rust
- 3
Núcleo em Rust — importação, extração, pesquisa (exata e semântica) e exportação
- 4
SQLite por projeto — metadados, trechos, índice FTS5 e vetores
- 5
Componentes locais opcionais — Tesseract (OCR), PDFium (evidência visual em PDFs digitais) e o modelo semântico, instalados à parte
O que o projeto faz
- Projetos independentes: cada um tem a própria pasta, o próprio banco SQLite e o próprio índice, e a pesquisa nunca mistura projetos
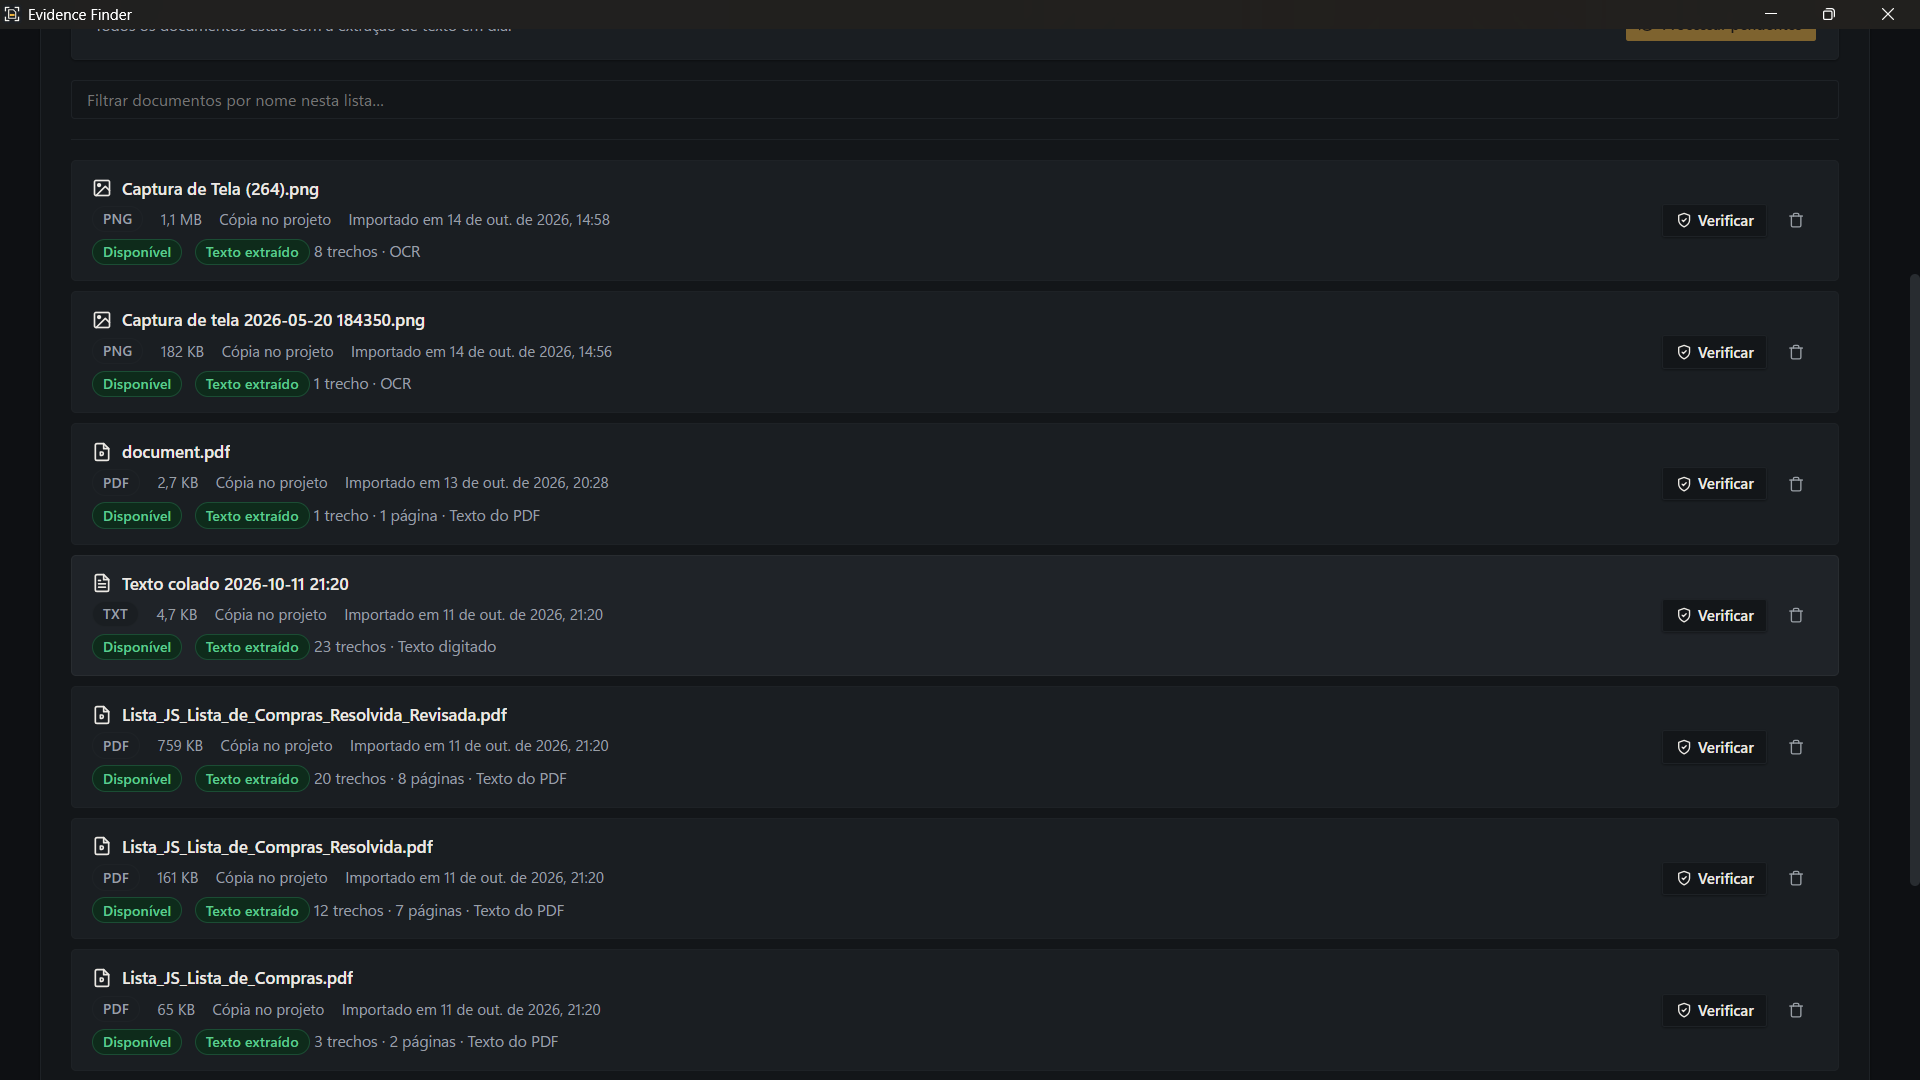
- Importação de PNG, JPEG, TXT e PDF, além de texto copiado, com formato conferido pelo conteúdo, detecção de duplicatas por SHA-256 e limite de 500 documentos por projeto
- Extração de texto de PDFs e TXT e OCR local de imagens e PDFs digitalizados via Tesseract (dependência externa, instalada à parte)
- Três modalidades de pesquisa: exata (SQLite FTS5), por significado (embeddings locais, com modelo instalado pelo usuário) e híbrida (fusão RRF), com filtros, ordenação e contexto dos trechos
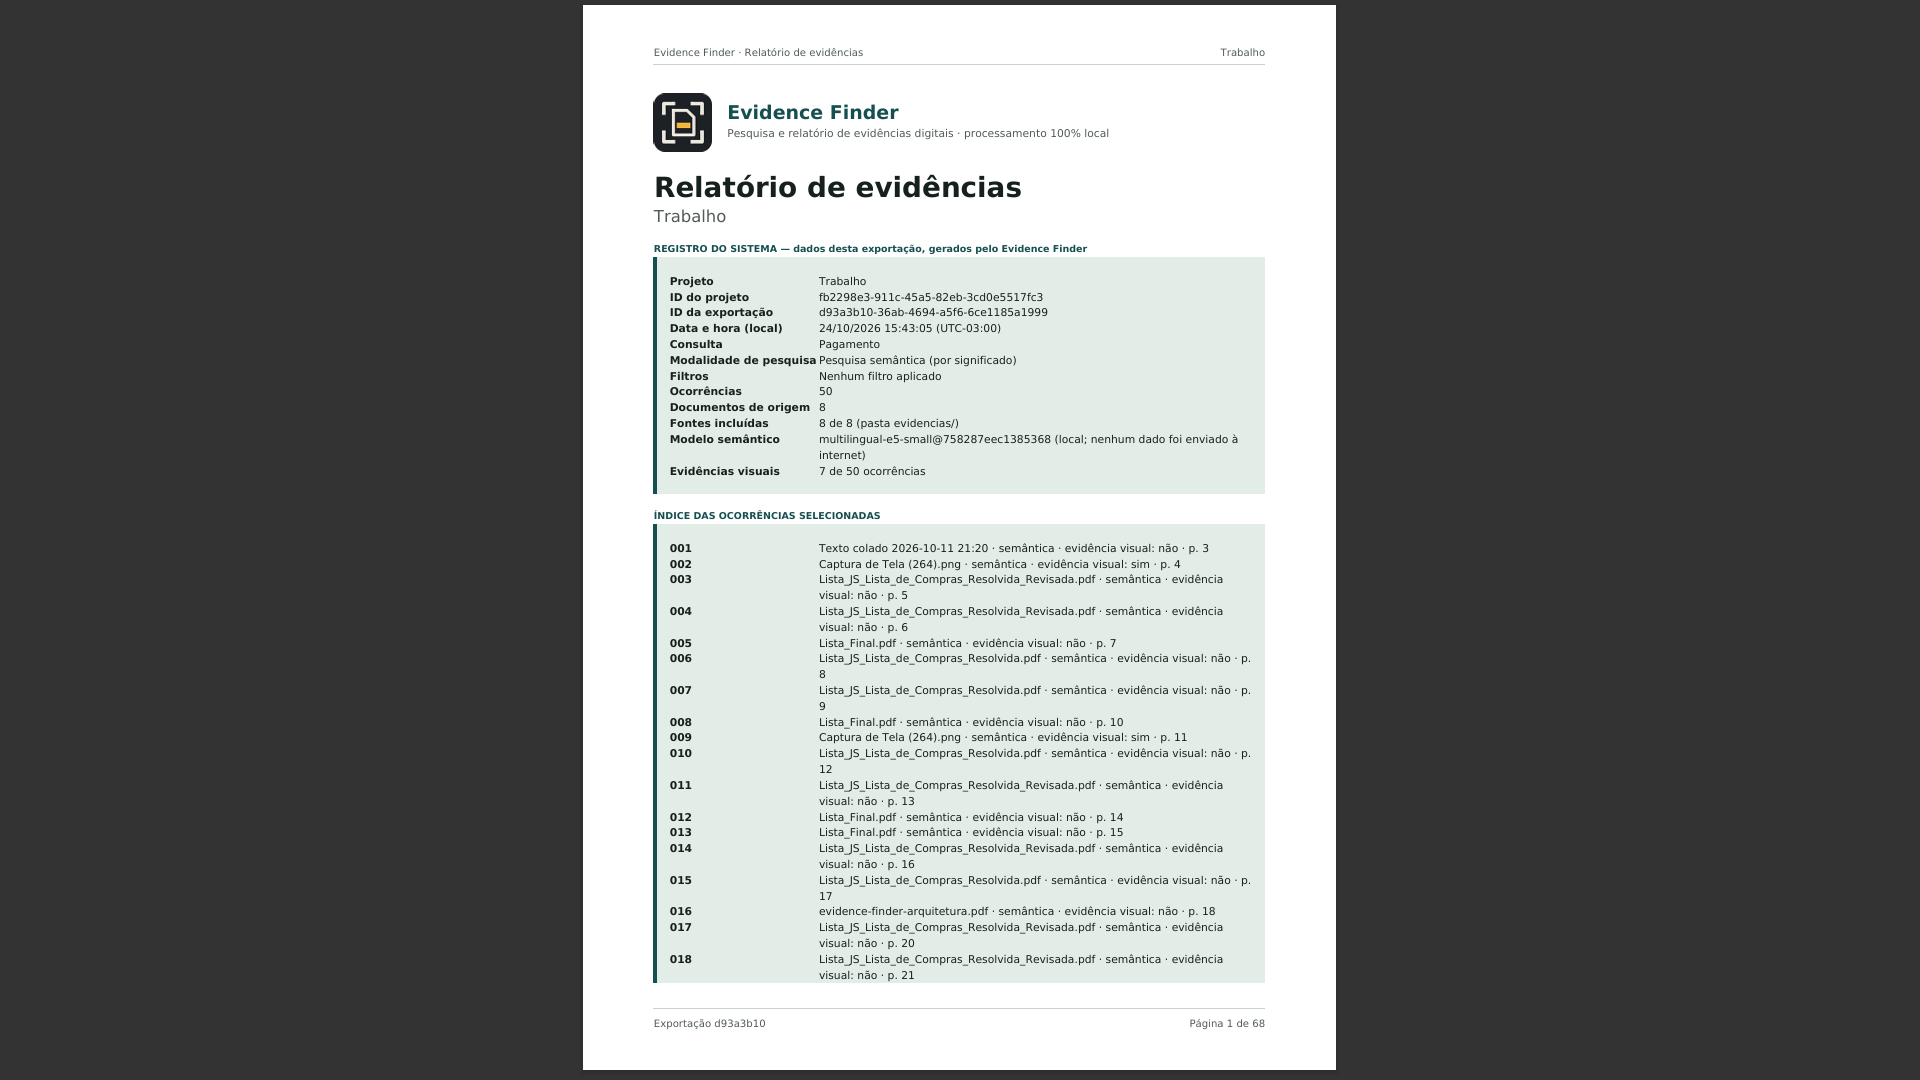
- Exportação dos resultados selecionados em relatório PDF, manifest.json e cópia das fontes cujo SHA-256 foi verificado
- Privacidade e segurança descritas no README: processamento local, permissões mínimas do Tauri, CSP restritiva, caminhos validados no núcleo e arquivos originais nunca alterados
Decisões técnicas
Estado atual
Versão 0.1.0, em desenvolvimento. Segundo o README, estão implementados e testados em Linux: projetos, importação, extração, OCR, pesquisa exata, a lógica do índice semântico, a exportação em PDF e o manifesto. Continuam pendentes: a validação do fluxo completo em um Windows real, o instalador Windows (o script de empacotamento nunca foi executado), os testes com o modelo semântico real e a calibração do limiar de similaridade.
Limitações declaradas
O armazenamento local não é criptografado, não há auditoria profissional de segurança e o app não protege contra malware nem contra outros usuários da mesma conta. O SHA-256 mostra que o conteúdo é idêntico ao registrado na importação, mas não comprova autenticidade, autoria nem cadeia de custódia. Ainda não existe Release para download.
Testes
Na última rodada registrada no repositório (docs/FASE7.md, em Linux), 82 testes de frontend (Vitest) e 258 testes Rust passaram. Outros 10 testes Rust ficam ignorados por dependerem de recursos externos, e os 4 testes do modelo semântico real não foram executados. São os números daquela rodada, não uma nova execução.
O que este projeto me ensinou
O Evidence Finder me tirou do ambiente web: aplicação desktop, linguagem de sistemas, persistência local, tratamento de arquivos não confiáveis e escolhas de segurança documentadas — inclusive o que o projeto ainda não garante.
Telas do projeto